LLM

(2件)
RTX2070(8GB)でStrataを利用してQwen3.8-Flash-Next(Q2)を動かしてみたメモ
カテゴリ: 日記 2026
タグ: AI LLM

どのくらい動くのか見たかった
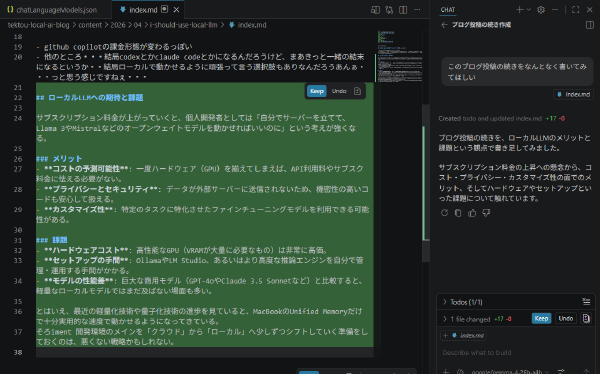
VSCodeのCopilot ChatでLMStudioで読み込んでいるローカルモデルを指定する
カテゴリ: Tips 2026
タグ: Copilot Chat LLM LMStudio VSCode ローカルLLM

VSCodeのCopilot ChatでLMStudioで読み込んでいるローカルモデルを指定することできそうわね